深知发布论文,规范性知识问答测评显著领先于知名知识库产品
时间:2026-9-22
作者:小智
分类:新闻
9 月 16 日,北京彩智科技团队的论文《Version- and Scope-Aware Question Answering over Normative Documents: A Deployed
System and an End-to-End Evaluation at Production Scale》在 arXiv 公开发布。
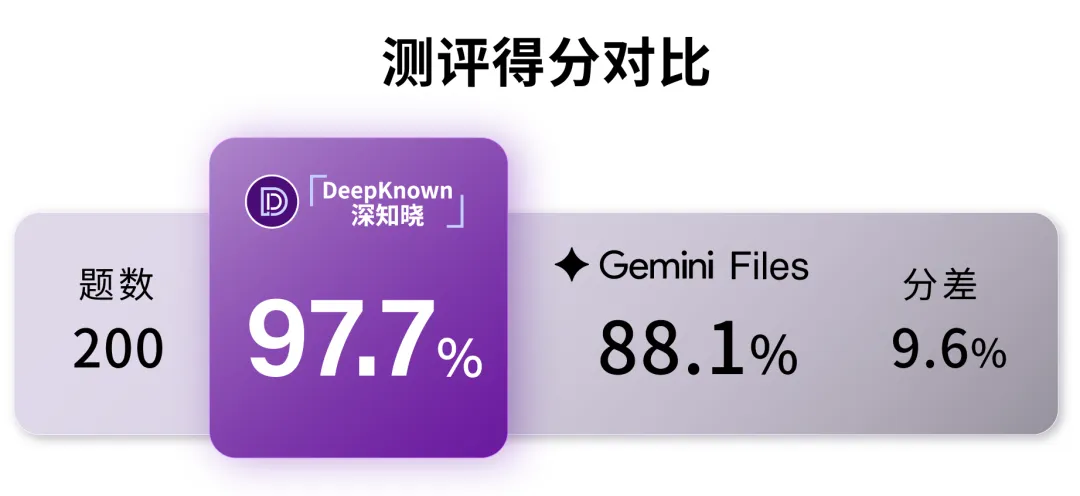
它讲的是一件很朴素的事:以公开发布的 7 万份规范性文件为测试数据,按“把文档上传给托管检索服务、然后直接提问”这个流行做法,端到端比了一次。 在200个题集上,对比测评谷歌的Gemini
Files与深知晓(基于深知可信知识模型,可公开访问的一个AI系统),深知取得显著优势。该测评题集、两个系统的逐题答案、评分和复算脚本全部公开。

北京彩智科技有限公司 · 深知可信
一、“规范性知识”的精准认知
——智能体可信应用的关键
——智能体可信应用的关键
需要说明的是,本次测评的数据集类型是深知可信专攻的规范性知识,而谷歌的知识库产品Gemini Files
是通用知识库产品,评测表明在规范性知识这个专业“赛道”上,DeepKnown深知可信有其独特的显著优势。
何谓“规范性知识( Normative
Knowledge)”?
这有一个背景,大语言模型应用已从对话问答组件演化为能够持续感知环境、分解任务、调用工具并依据反馈修正行动的Agent。对应的,知识问题的重心也随之变化。知识库主要重心是优化材料的收集、索引标注与召回准确率,而面向Agent的认知基础设施,在各行业的严肃应用场景下,还需支持更严格的认知操作:识别讨论对象,确定概念含义与规则要求,选择适用版本,取得相关事实,判断证据能否支撑结论,并在信息不足时识别出未知。在这个Agent应用的“深水区”,对规范性知识能做到精准、无幻觉或低幻觉的认知,是个关键能力。
这有一个背景,大语言模型应用已从对话问答组件演化为能够持续感知环境、分解任务、调用工具并依据反馈修正行动的Agent。对应的,知识问题的重心也随之变化。知识库主要重心是优化材料的收集、索引标注与召回准确率,而面向Agent的认知基础设施,在各行业的严肃应用场景下,还需支持更严格的认知操作:识别讨论对象,确定概念含义与规则要求,选择适用版本,取得相关事实,判断证据能否支撑结论,并在信息不足时识别出未知。在这个Agent应用的“深水区”,对规范性知识能做到精准、无幻觉或低幻觉的认知,是个关键能力。
规范性知识,是指依赖有权主体定义、发布、配置、授权、记录或运行,并受版本、时间、对象、地区、产品、状态或权限等条件约束的知识。论文把规范性知识与通用知识做了区分:通用知识(自然规律、科学事实、常识)的正确性可以靠验证、共识或推理来支撑;规范性知识则是人为设定的,对它的任何执行、判断或答复都必须回溯到适用范围正确的文档原文。它不限于法律和政策——行业标准、服务清单、业务规程、合同条款、客服规范、产品手册,都是规范性文档。
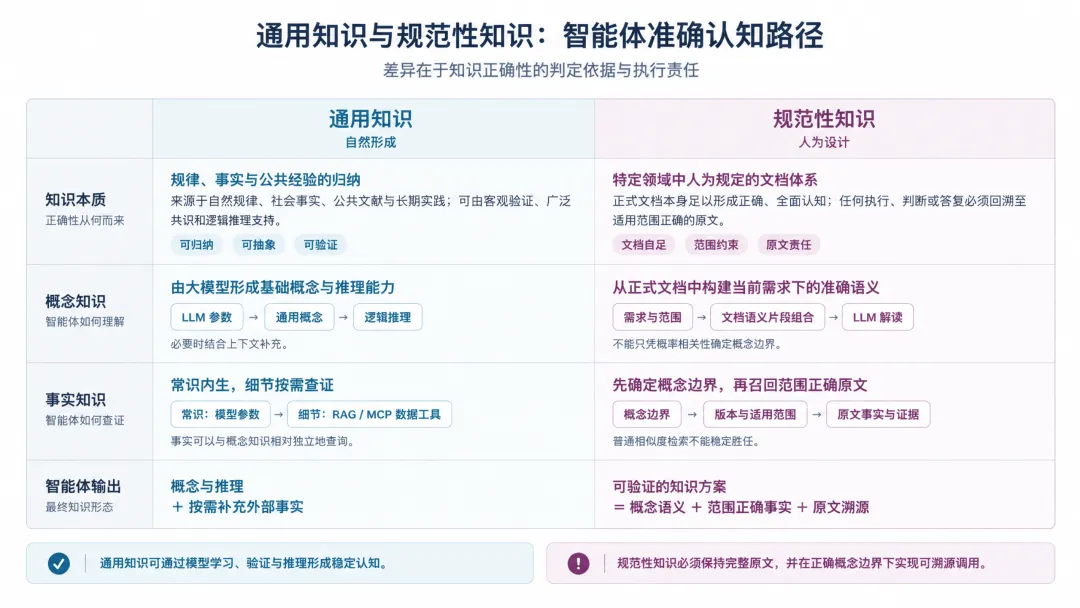
图 1 通用知识与规范性知识的性质及智能体准确认知路径比较(引自论文)
对规范性知识的服务,不是“从文档里排序出语义相似度最高的答案”,而是确定在当前需求下哪些文档和条款构成可采用的证据,并保持原文依据与责任链条。
北京彩智科技有限公司 · 深知可信
二、深知可信知识模型做了什么?
深知可信知识模型与常见的检索增强系统在广义上属于同一类,差别在于:那些决定一份文件“到底适不适用”的约束——发布主体、效力状态、生效日期、适用地域和对象、替代关系——存放在哪里。
Gemini files或其它流行的知识库系统没有接口去强制这些约束,它们只能作为普通词语残留在被索引的文本里,过滤发生在一个看不见的排序器内部。
深知晓的做法是在入库时就把这些约束抽取出来,作为类型字段与正文并列存放,并在排序之前以硬性谓词的方式强制执行。论文里讲了三个设计决策:
1.用硬性谓词,不用相似度加权
软性加权可以被其他排序信号抵消,硬性谓词不会。代价是可能损失召回,所以系统按固定顺序、每次只放宽一个维度;放宽用尽仍没有合格证据时,不输出缺乏依据的结论。
2.版本谱系做成字段,不写进切片正文
替代关系往往在旧文件入库之后才被发现,字段只需更新一条边,而写进正文就要重做整条谱系。
3.用外部证据检验决定要不要作答,而不是让模型自评
只有当保留下来的证据满足问题的适用范围与版本约束时才作答;证据不足就说明缺的是什么,而不是给出一个“最像”的数字。
北京彩智科技有限公司 · 深知可信
三、本次测评概况
对比对象
Gemini File——一项流行的托管检索服务型知识库,也是“上传就问”这一默认做法的代表。
两个系统输入的是同一批约 7 万份候选规范性文件,回答同样的 200 道题,由同一个大模型裁判、同一份评分卡打分;裁判看不到系统身份,也看不到引用信息。
题 集
200 道题均有标准来源文档,覆盖 191 份不同文件。
它们是从我们已发布的基准中按固定规则抽出的分层随机样本——抽样只依据题型和来源文档所属地市,不读取任何分数或答案;抽样脚本随数据一并公开,任何人都可以逐字节重建。
结 果
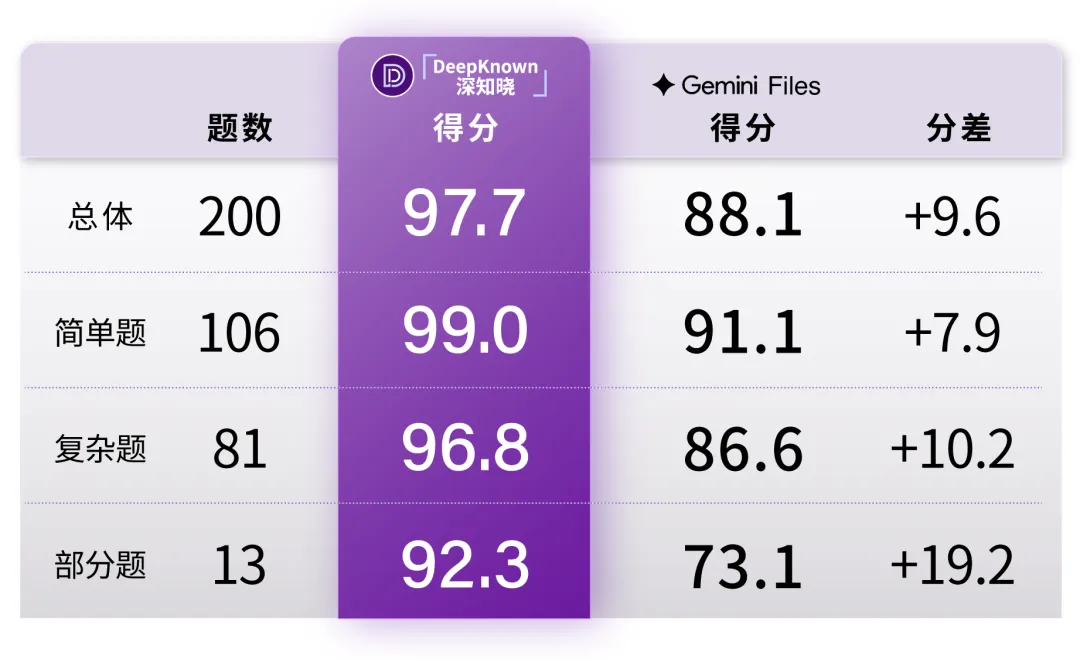
总体分差 9.6 分,配对自举 95% 置信区间 [5.7, 13.8],不包含零;简单、复杂、部分三类题的方向一致。深知晓在 200 道题中没有一道得零分。
差距最大的一类是部分题——语料只支持答案的一部分,正确的输出是说明哪部分有依据、哪部分没有。类似于Gemini
Files这样的没有显式可采性检验的知识库系统倾向于用检索到的材料把答案“补全”;深知晓则停在证据的边界上。会不会补全,是两种设计的分水岭。
北京彩智科技有限公司 · 深知可信
四、这个结果应该怎么读
论文对结论的边界写得很克制,这里照实转述:
• 这是一套题集、一个领域、一对系统之间的整系统端到端对比。
• 200 道题是已发布 420 道可答题的分层随机子集。换不同随机种子抽样,分差在 +7.6 到 +12.7 之间波动,全集上是 +11.0;9.6
是这个分布里的一次抽样,不应读成“效应更小”或“更大”。要更紧的估计,请用全集——它也在同一个仓库里。
• 它证明的不是“谁更先进”,而是:在这个领域、在系统实际运行的语料规模上,那些决定文件是否适用的约束,值得放在可检视的地方强制执行,而不是交给一个看不见的排序器。
北京彩智科技有限公司 · 深知可信
五、全部公开
论 文
arXiv :2609.18769
https://arxiv.org/abs/2609.18769
arXiv :2609.18769
https://arxiv.org/abs/2609.18769
题集、逐题答案与评分、抽样规则、复算脚本
github.com/ASI2030/normative-qa-benchmark/tree/main/subset-200
一条命令即可重算论文中的每一个数字;全集在同一仓库
github.com/ASI2030/normative-qa-benchmark/tree/main/subset-200
一条命令即可重算论文中的每一个数字;全集在同一仓库
系统可自助注册试用
https://yun.dknowc.cn/wlcb/dknowc-chat/
https://yun.dknowc.cn/wlcb/dknowc-chat/

彩智科技
公司地址:北京市海淀区中关村东路18号财智国际大厦A座17层
邮编:100081
客服邮箱:sc@czkj1010.com
联系方式:010-62526890
 深知智能公众号
 深知智能小程序
版权归北京彩智科技有限公司所有
京公网安备11010802046034号
京ICP备16055611号-1