专业的办公"Jev”模型:深知DKnown-Jev 让规范性工作更准确
时间:2026-10-22
作者:小智
分类:新闻
Jev 的走热,让决策模型受到更多关注:面对明确的业务问题,AI能否依据给定条件,作出可靠的判断?
决策模型走进专业业务,需要进一步适配具体场景中的规则与判断标准。如何让模型理解这些要求,并在实际任务中验证判别能力,是我们研发业务专用决策模型的出发点。
业务规则定义得清楚,
模型判断才有明确的专业标准。
模型判断才有明确的专业标准。
基于这一业务方向,我们研发了 DKnown-Jev,专项判断候选内容能否作为当前问题的答案证据。
在本次 1,120 条同样本业务评测中,DKnown-Jev 27B(1 轮)的准确率达到 98.75%,较商业 Jev 提高 6.07 个百分点;Macro-F1 达到 98.60%,提高 6.76 个百分点。在这项规范性业务任务上,我们的专项配置取得了更好的判别效果。
01#
北京彩智科技有限公司
我们的专业方向
专业,
体现在对业务边界的准确理解
体现在对业务边界的准确理解
政策咨询、资格认定、流程说明、材料要求,以及产品服务和计费规则解答,都需要以有权主体发布、维护或记录的规则与事实为依据。我们将这类业务活动称为“规范性工作”。
在这些场景中,判断一段内容能否用于回答,需要同时关注对象、地区、时间、事项、业务环节和规则版本,还要看它是否包含问题所需的答案信息。
一个容易遇到的情况
用户咨询甲地某项业务的办理材料,检索结果中出现了一份乙地同名业务的材料清单。两者主题高度相关,但如果没有信息证明该清单适用于甲地,就不能直接拿来答复。
反过来,如果一项适用范围更广的规则确实覆盖用户的办理条件,并提供所需信息,也可以成为答案依据。
以上为业务示意,用于说明判别逻辑,并非测试集中的具体案例。
DKnown-Jev 关注的,正是内容与具体问题之间的这种关系:内容是否适用,能否提供明确的答案支持。
02#
北京彩智科技有限公司
核心能力
给候选内容
一个明确的证据判断
一个明确的证据判断
DKnown-Jev 将用户问题及其条件、文章标题与地域等属性、候选内容共同作为判别依据,输出两类结果:
AE · 答案证据
能够直接回答问题,或提供答案的明确组成部分。既可以是一段完整答复,也可以是适用条件明确、能够回答部分要求的内容。
NE · 非答案证据
仅能辅助理解问题,或与问题没有实质关联。背景介绍、词语重合,都不自动意味着能够作为答复依据。
文章属性同样参与判断。文本中未明确说明的地域或时间信息,可能需要从文章上下文中获得。但发布日期不等于生效日期,发布主体也不能自动证明规则仍然有效。判断以可见信息为依据,不补设缺失条件。
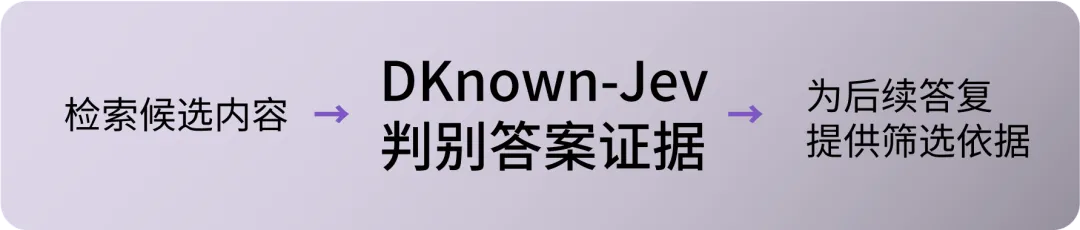
模型判断的是内容在具体问题下的可用程度,并非对文件法律效力的评级。
03#
北京彩智科技有限公司
专业如何进入模型
把业务理解,
转化为可训练、可评测的标准
转化为可训练、可评测的标准
业务专业性需要落实为具体的分类规范:什么内容能够回答问题,什么只是背景,哪些适用条件必须有信息支持。围绕这些判断标准,我们将答案证据与非答案证据的边界写入任务定义,并组织了 26,064 条人工校验训练记录。每条记录对应一个问题与一个候选内容,并保留可获得的文章属性,让模型在业务上下文中学习判别。
在模型结构上,DKnown-Jev 对各候选类别分别评分,再输出类别概率与标签;通过 LoRA 领域微调,联合训练适配参数和共享评分头,使模型表征与评分规则共同适配业务要求。
本次研究包含 2B 与 27B 两种配置,分别从 Qwen3.5-2B 与 Qwen3.8-27B 原生基座直接微调,并比较各自训练 1 轮、2 轮后的表现。
04#
北京彩智科技有限公司
评测结果
在专项业务评测中,
效果优于商业 Jev
效果优于商业 Jev
在政策与公共服务问题组成的 1,120 条人工校验测试样本上,我们对商业 Jev 与四组 DKnown-Jev 配置进行了同样本比较。测试集包括 378 条答案证据、742 条非答案证据。
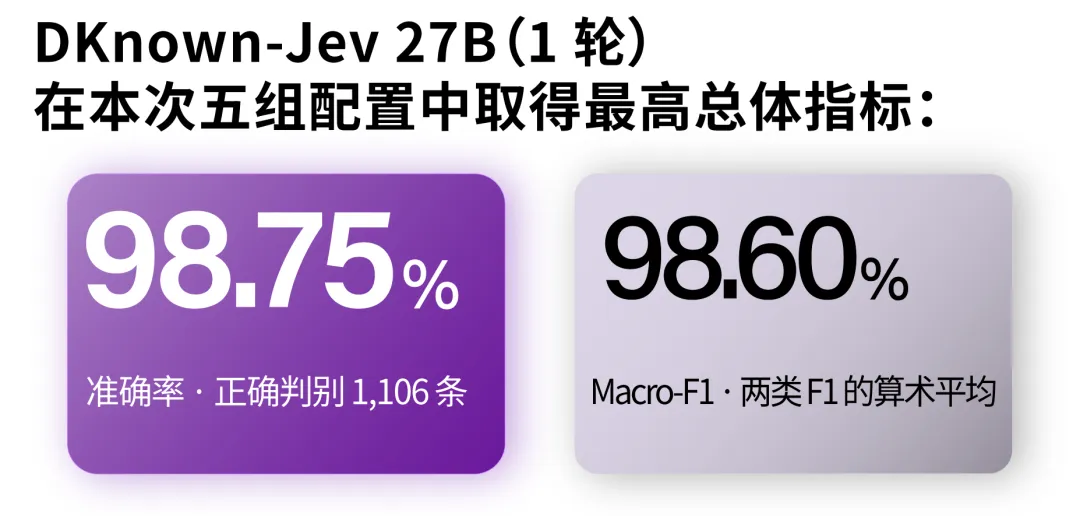
相较 Jev,准确率提高 6.07 个百分点,Macro-F1 提高 6.76 个百分点。
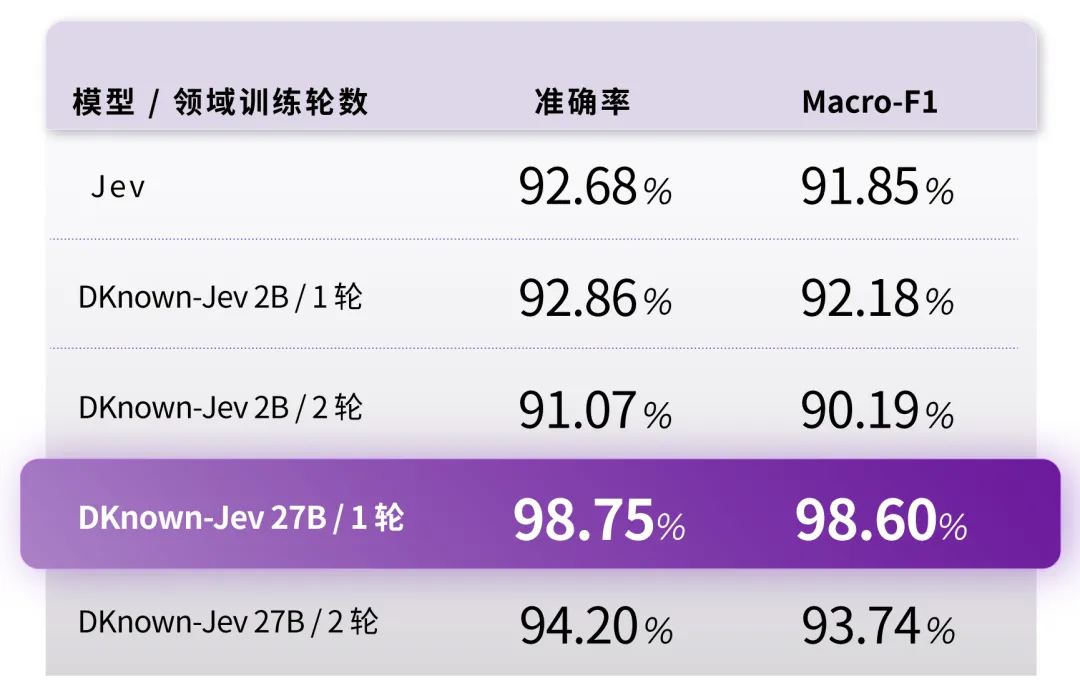
2B(1 轮)是本次已测 2B 配置中总体指标最好的一组,其准确率与 Macro-F1 分别为 92.86% 和 92.18%。
05#
北京彩智科技有限公司
业务价值
以专业业务为起点,
让决策能力落到实处
让决策能力落到实处
从政策与公共服务咨询,到制度管理、产品服务和计费规则解答,规范性工作都对答案依据提出了明确要求。我们专注的,就是将这些业务要求转化为模型能够学习、业务能够检验的判断能力。
我们希望通过对问题条件、文章属性和候选内容的联合判断,帮助业务系统更清楚地识别:哪些内容可以支撑答案,哪些内容只能作为背景。

彩智科技
公司地址:北京市海淀区中关村东路18号财智国际大厦A座17层
邮编:100081
客服邮箱:sc@czkj1010.com
联系方式:010-62526890
 深知智能公众号
 深知智能小程序
版权归北京彩智科技有限公司所有
京公网安备11010802046034号
京ICP备16055611号-1